はじめに
こんにちは。人材プラットフォーム本部 第一開発グループ プラットフォームチームの坂井(@Hiroshi_mars)です。
ジョブメドレーの求職者向けアカウント300万件以上の認証情報(メールアドレスとパスワードハッシュ)を、Ruby on Rails で作られたサービス本体のデータベースから、社内の共通 ID 基盤へ移行しました。2026年5月に本格的に着手し、8月に本番へリリースしています。
移行の間も求職者のログイン状態を保ち、サービスを止めずに切り替えました。リリースは大きな障害なく完了しています。
この記事で紹介するのは次のことです。
- AWS DMS と AWS Lambda を組み合わせた、MySQL から DynamoDB への移行パイプライン
- 移行済みの事業者向けアカウントと同じテーブルに、求職者向けアカウントを同居させた方法
- ログイン中の人をログアウトさせずに認証の仕組みを切り替えた設計
- 深夜のフィーチャーフラグ切り替えと、「止める」「消す」を分けた段階的な撤去
- 設計から実装・プロジェクト管理までを一人で進める中での、AI の使い方
なぜ移行したのか
ジョブメドレーには、求職者向けのアカウントと、求人を掲載する事業者向けのアカウントがあります。これまではどちらも、サービス本体のデータベース(Amazon Aurora MySQL)で認証情報を管理していました。
社内には、複数のサービスで使える共通 ID 基盤があります。認証情報の管理をここへ集めることで、次のことができるようになります。
- 認証と ID 管理の責務を、サービス本体から切り離せる
- コード面: パスワードの照合やハッシュ化といった認証の処理を、サービスごとに持たずに共通 ID 基盤の一か所にまとめられる。事業者向けと求職者向けのように、同じサービスの中の複数の種類のアカウントも同じ実装で扱える。認証の仕組みを変えるときも、サービス本体の改修を最小限にできる
- セキュリティ面: パスワードの照合を共通 ID 基盤に集約できる(サービス本体側のパスワードハッシュは、ログイン状態の確認のために残していますが、照合には使いません。詳しくは後述の「ログイン中かどうかの確認は Rails に残す」で説明します)。不正なログインの試行への対策も共通 ID 基盤で行っているので、つながっている全てのサービスに効く
- サービス本体を開発するチームが、認証の細かな仕組みを意識せずに済む
移行の要件
求職者は移行の間も普段通りサービスを使っています。そこで、次の4つを要件にしました。
- ログアウトさせない: 既にログインしている人のログイン状態を保つ
- パスワードを再設定させない: 移行後も、これまでと同じパスワードでログインできる
- サービスを止めない: メンテナンス画面を出さずに切り替える
- 戻せる: 問題が起きたら、切り替え前の状態に戻せる段階を残す
方式: 約16万件で確立した方式を、20倍近い規模へ
事業者向けアカウント約16万件は、既に共通 ID 基盤への移行を終えていました。今回はその方式を求職者向けアカウントに展開しています。ただし、求職者向けアカウントは300万件以上と20倍近い規模です。そのため、リリースの進め方は規模に合わせて変えました(後述の「移行のフェーズ」で説明します)。
先行した移行から引き継いだものと、今回変更したものをまとめます。
| 項目 | 事業者向けの移行 | 今回の求職者向けの移行 |
|---|---|---|
| 移行パイプライン | AWS DMS → 中間テーブル → Lambda の構成 | 同じ構成を引き継ぎ、300万件以上のフルロード時間と CDC の追従を検証 |
| 移行先のデータ | 事業者向けアカウントを格納 | 同じテーブルに求職者向けアカウントを追加し、テナントと種別で照合対象を区別 |
| Rails 側の同期処理 | 事業者向けアカウント専用 | 種別を引数で受け取る共通処理に変更し、求職者向けにも対応 |
| リリースの進め方 | パイプラインの構築から撤去まで一晩で完了 | 前日の日中から同期し、保険経路の停止と削除の間に1週間の観察期間を設ける |
以下では、引き継いだパイプラインの構成を説明したうえで、同じテーブルでのアカウントの区別と同期処理の共通化、ログアウトさせない設計、段階的なリリースを順に紹介します。
AWS DMS と中間テーブルを使った3段構成
移行には AWS Database Migration Service(AWS DMS)を使いました。移行元は Aurora MySQL、移行先は共通 ID 基盤が使う Amazon DynamoDB です。
構成は次の3段です。
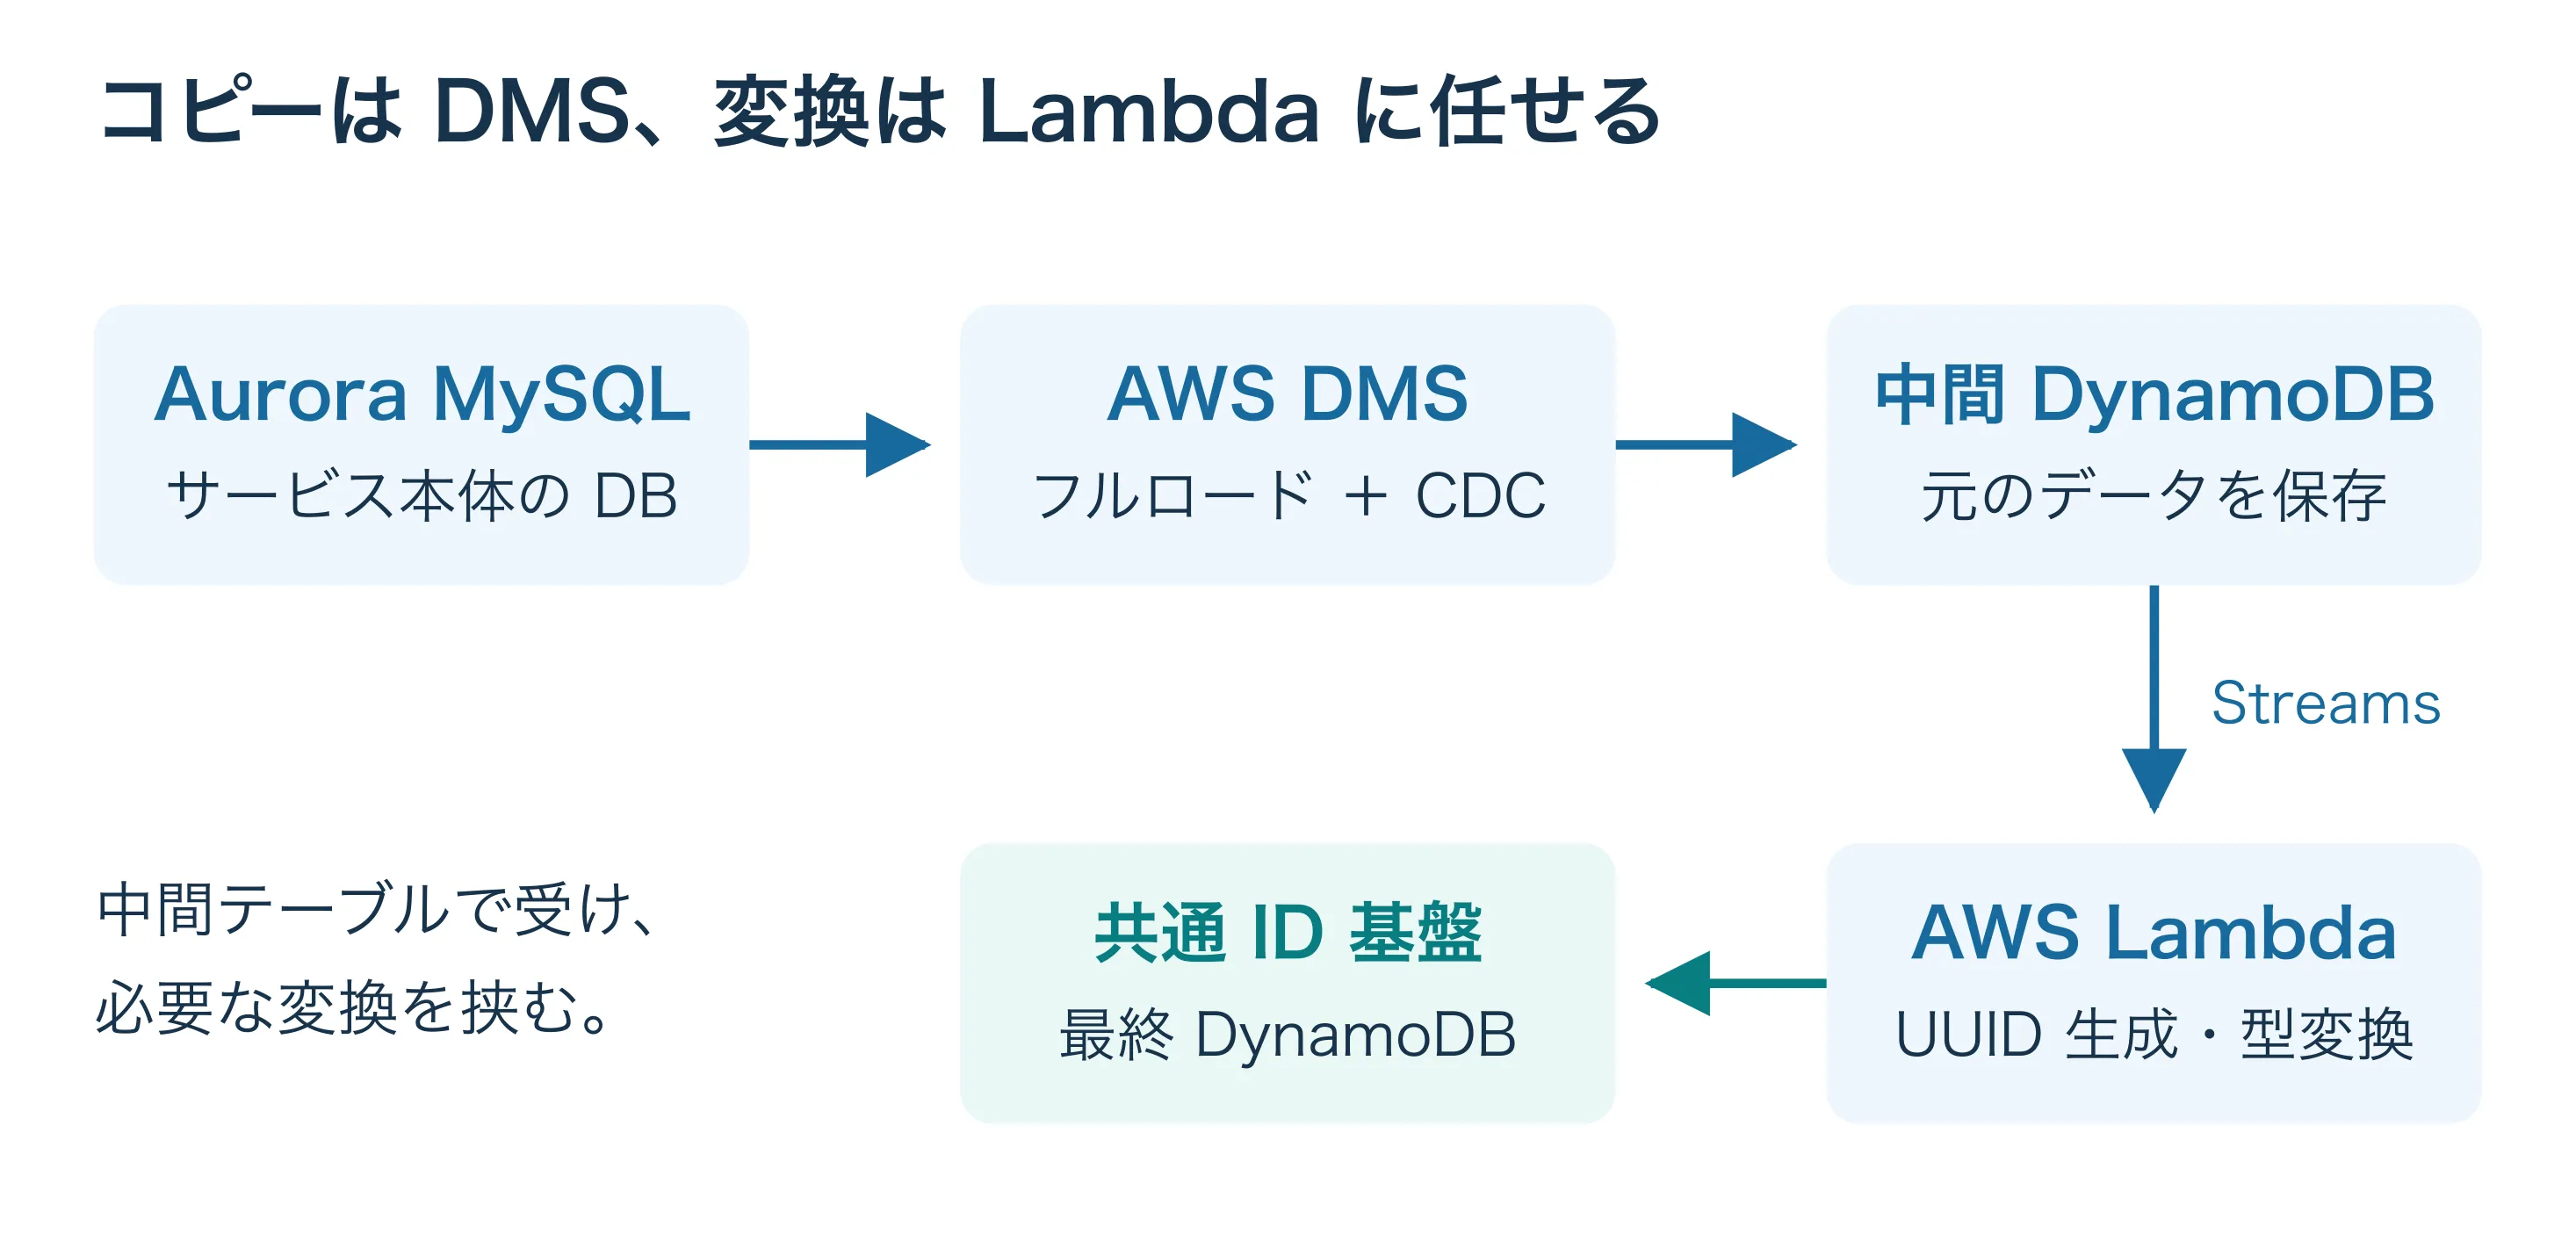
AWS DMS は、既存のデータを全件流し込む「フルロード」と、その後に発生した変更を流し続ける「CDC(Change Data Capture)」を一つのタスクで実行できます。移行を始めた時点のデータをコピーした後も、サービス上での登録や変更を追いかけて反映し続けられるため、サービスを止めずに移行できます。
途中に中間テーブルを挟んだのは、AWS DMS だけではデータの変換が足りなかったためです。共通 ID 基盤では各アカウントに UUID 形式の ID を持たせますが、AWS DMS にはこの ID を生成する機能がありません。そこで AWS DMS は一旦中間テーブルにそのまま書き込み、DynamoDB Streams で変更を受け取った AWS Lambda が、ID の生成と型の変換をしてから最終テーブルに書き込む形にしました。
データの型で気を付けたこと
MySQL と DynamoDB の間では、データの型の扱いが違います。
例えば、MySQL の整数型の ID は、AWS DMS を通すと DynamoDB の数値型(Number)として書き込まれます。中間テーブルのキーを文字列型(String)で作ってしまうと、型が合わずにフルロードが止まります。そこで、中間テーブルのキーは数値型で作り、文字列型への変換は Lambda で行うようにしました。
移行済みの事業者向けアカウントとどう区別したか
共通 ID 基盤の最終テーブルは、サービス単位で一つです。求職者向けアカウントは、既に事業者向けアカウントが入っている同じテーブルに書き込みます。
テーブルを分けずに同居させるため、各アカウントに次の2つの属性を持たせて区別しています。
- テナント名: どのサービスのアカウントか(今回はどちらもジョブメドレー)
- 種別名: そのサービスの中で、どの種類のアカウントか(求職者向けか事業者向けか)
ログイン時のパスワード照合も、この2つで対象を絞ってから行います。求職者向けのログイン画面で、事業者向けアカウントのメールアドレスとパスワードが照合されることはありません。
ID は、テナント・種別などの情報から UUID v5 で決定的に生成しています。UUID v5 は、同じ入力からは必ず同じ UUID ができる方式です。これには2つの利点があります。
- 求職者と事業者で ID が衝突しない
- 同じアカウントを何度書き込んでも同じ ID になるので、再送や二重実行があっても重複したアカウントが生まれない
サービス本体の Rails 側では、共通 ID 基盤とデータを同期する処理が、元々事業者向けアカウント専用に作られていました。今回はこれを、種別を引数で受け取る共通の処理に作り直しました。求職者向けと事業者向けで同期の流れは同じにして、違う部分だけを種別で分けています。
ログアウトさせない仕組み
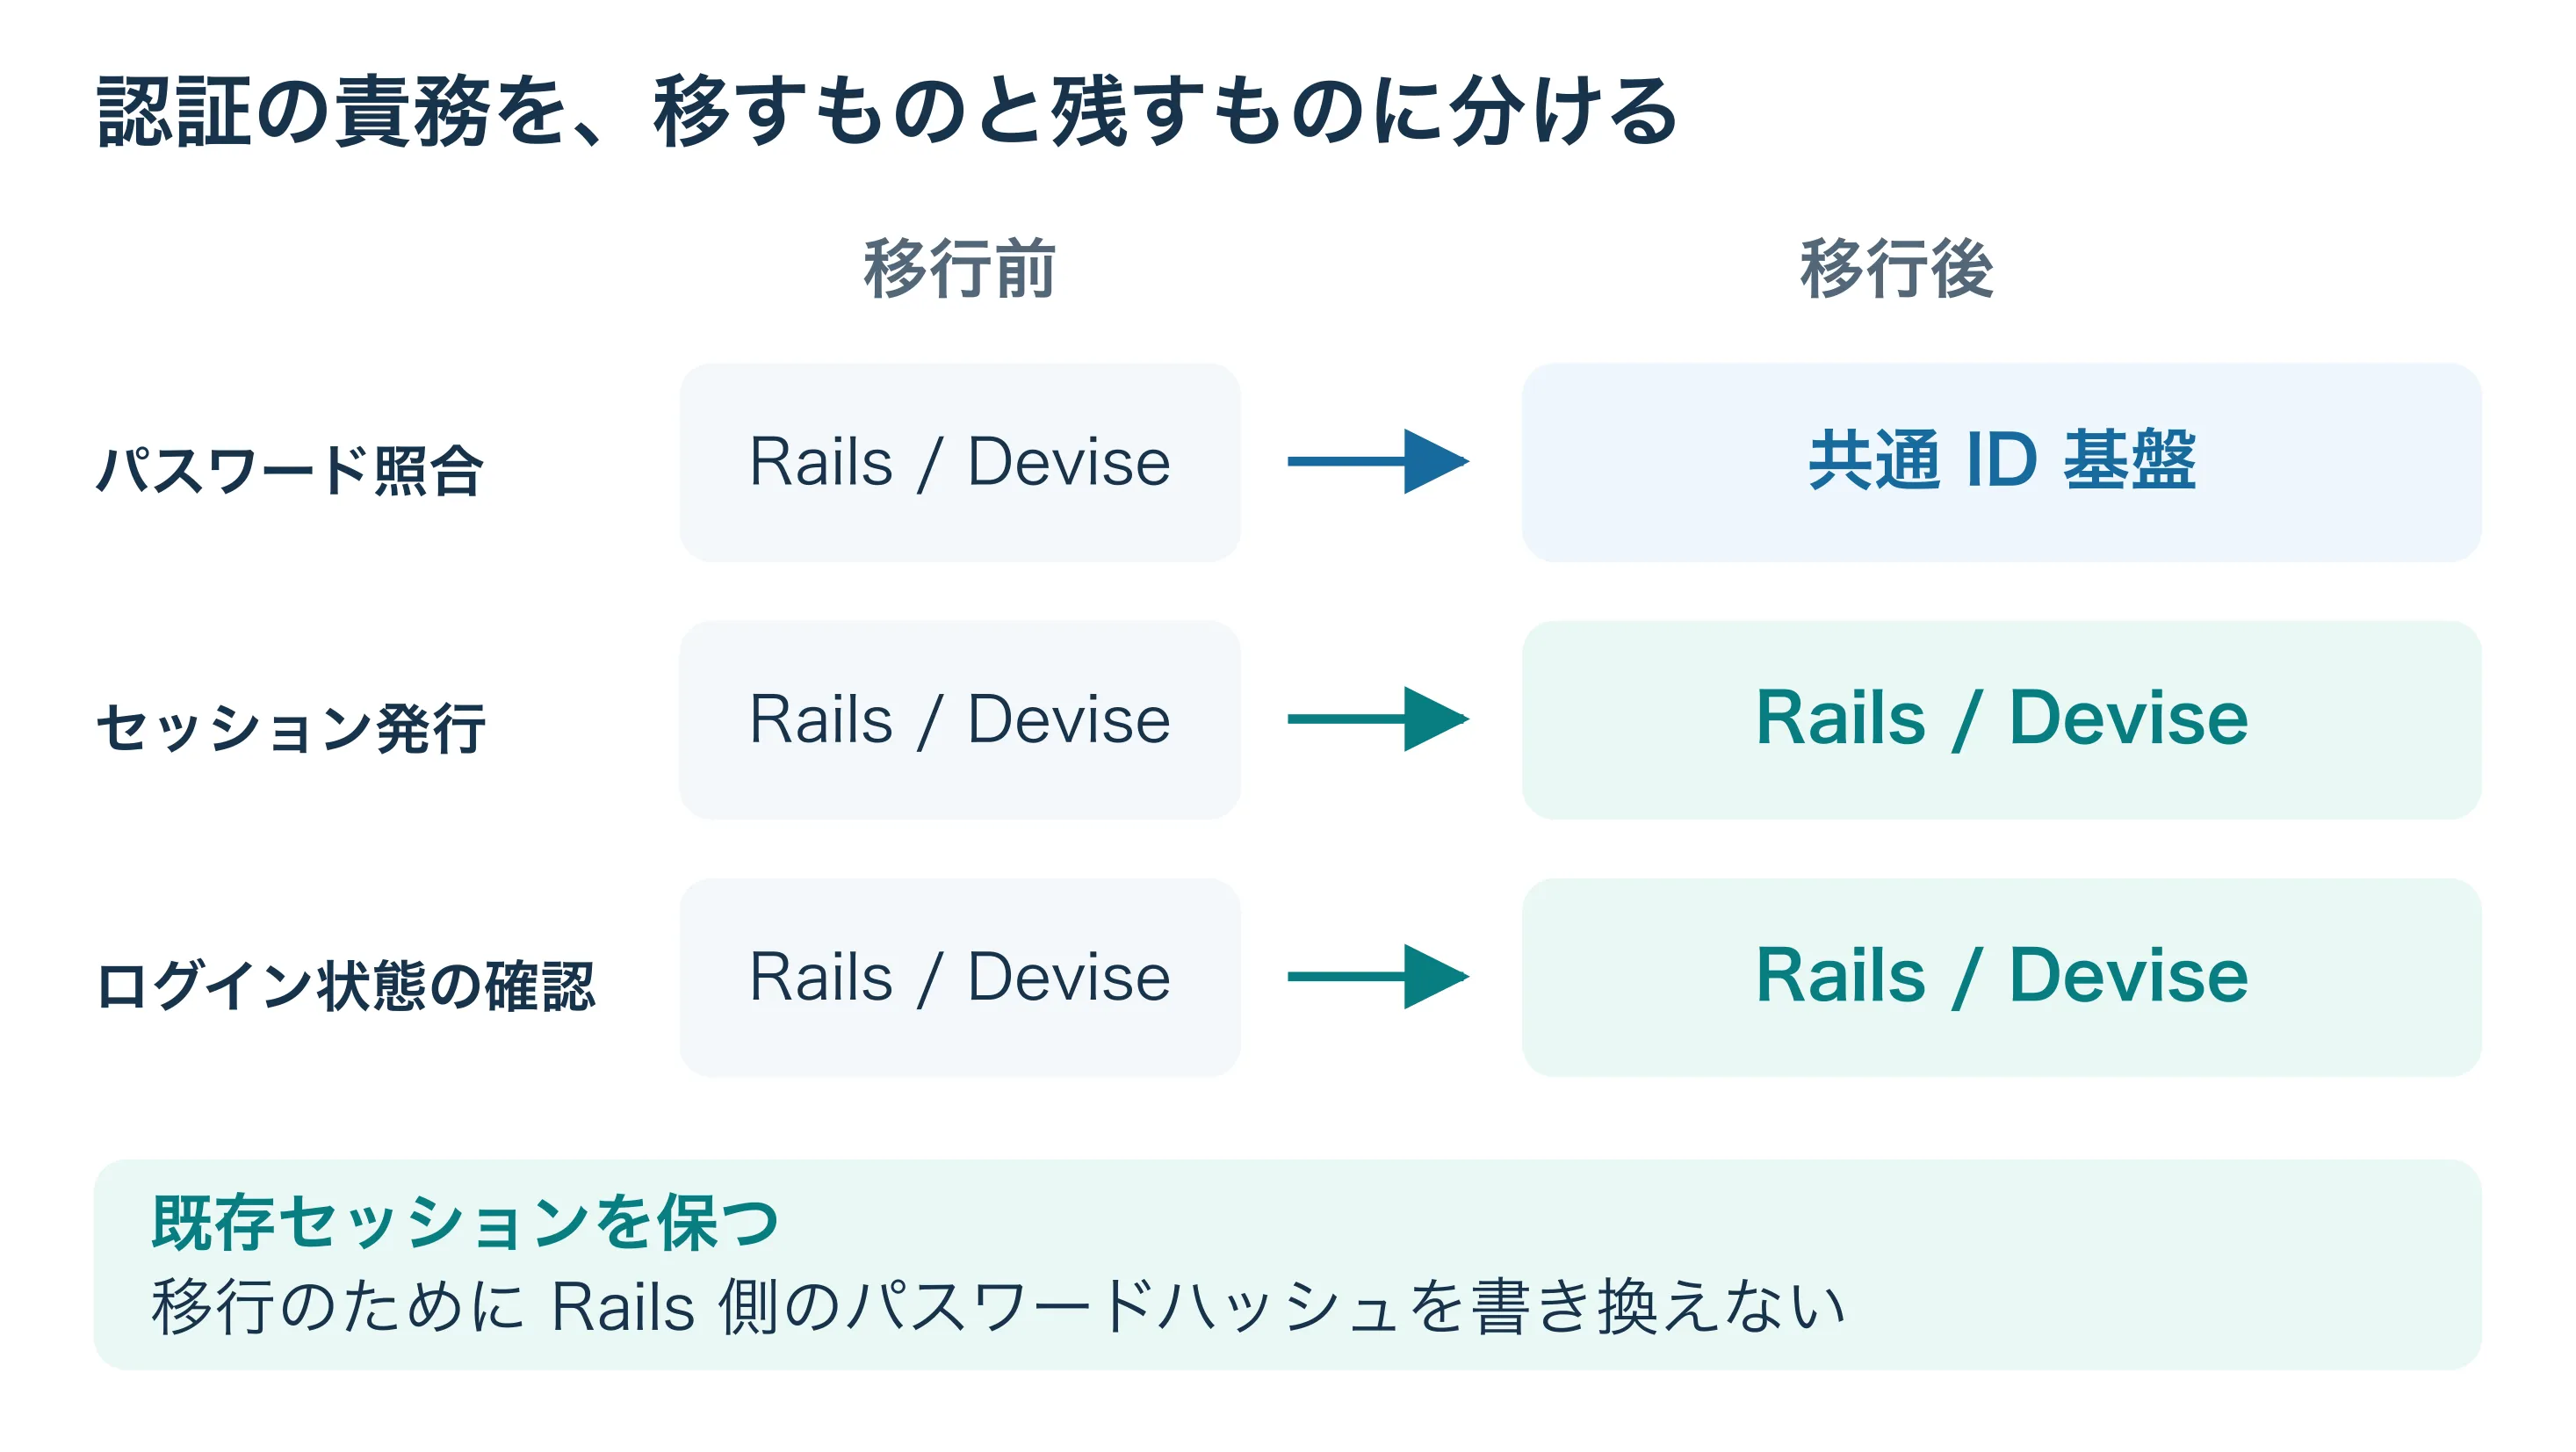
ポイントは、「ログイン中かどうかの確認」は移さず、「パスワードの照合」だけを移したことです。
ログイン中かどうかの確認は Rails に残す
ジョブメドレーのログインは、Rails の認証ライブラリ Devise で実装しています。Devise の処理は大きく2つに分かれます。
- パスワードの照合: ログイン画面で入力されたメールアドレスとパスワードが正しいかを確かめる
- ログイン状態の確認: ログイン後のリクエストごとに、セッションや Cookie が正しいかを確かめる
今回、共通 ID 基盤へ移したのは前者だけです。Devise には、認証の方法を差し替える「ストラテジー」という仕組みがあります。パスワードを照合するストラテジーを、共通 ID 基盤の API を呼ぶものに差し替えました。照合に成功した後のセッションの発行と、その後のログイン状態の確認は、これまで通り Rails が行います。
ログイン状態の確認には、サービス本体のデータベースに保存されているパスワードハッシュから導いた値が使われます。この値が変わると、Cookie が正しくないと判定され、その人はログアウトされます。そこで、移行のためにサービス本体のデータベースのパスワードハッシュを書き換えることはしないと決めました。値が変わらないので、ログイン中の人のセッションはそのまま有効です。
この挙動は、検証環境でハッシュだけを書き換えるとすぐにログアウトされることを実際に確かめたうえで、設計の前提にしています。
パスワードハッシュは再ハッシュせずに持っていく
パスワードは bcrypt でハッシュ化して保存しています。平文のパスワードはどこにも残っていないので、移行のために計算し直すことはできません。
そこで、ハッシュを再ハッシュせず、そのまま共通 ID 基盤へ複写しました。bcrypt のハッシュには照合に必要な情報が含まれているため、別の環境に移しても同じパスワードで照合できます。
照合に成功すると、共通 ID 基盤は元のデータベースでの ID を返します。Rails はその ID でサービス本体の会員データを引き、これまでと同じようにセッションを発行します。求職者から見ると、ログイン画面もパスワードも何も変わっていません。
移行中の変更は2つの経路で取りこぼさない
移行の間も、新規登録・パスワード変更・メールアドレス変更は起きています。これを取りこぼさないために、2つの経路を並行して動かしました。
- 主経路: Rails が、サービス本体のデータベースと共通 ID 基盤の両方に直接書き込む
- 保険経路: AWS DMS の CDC が、サービス本体のデータベースの変更を共通 ID 基盤へ流す
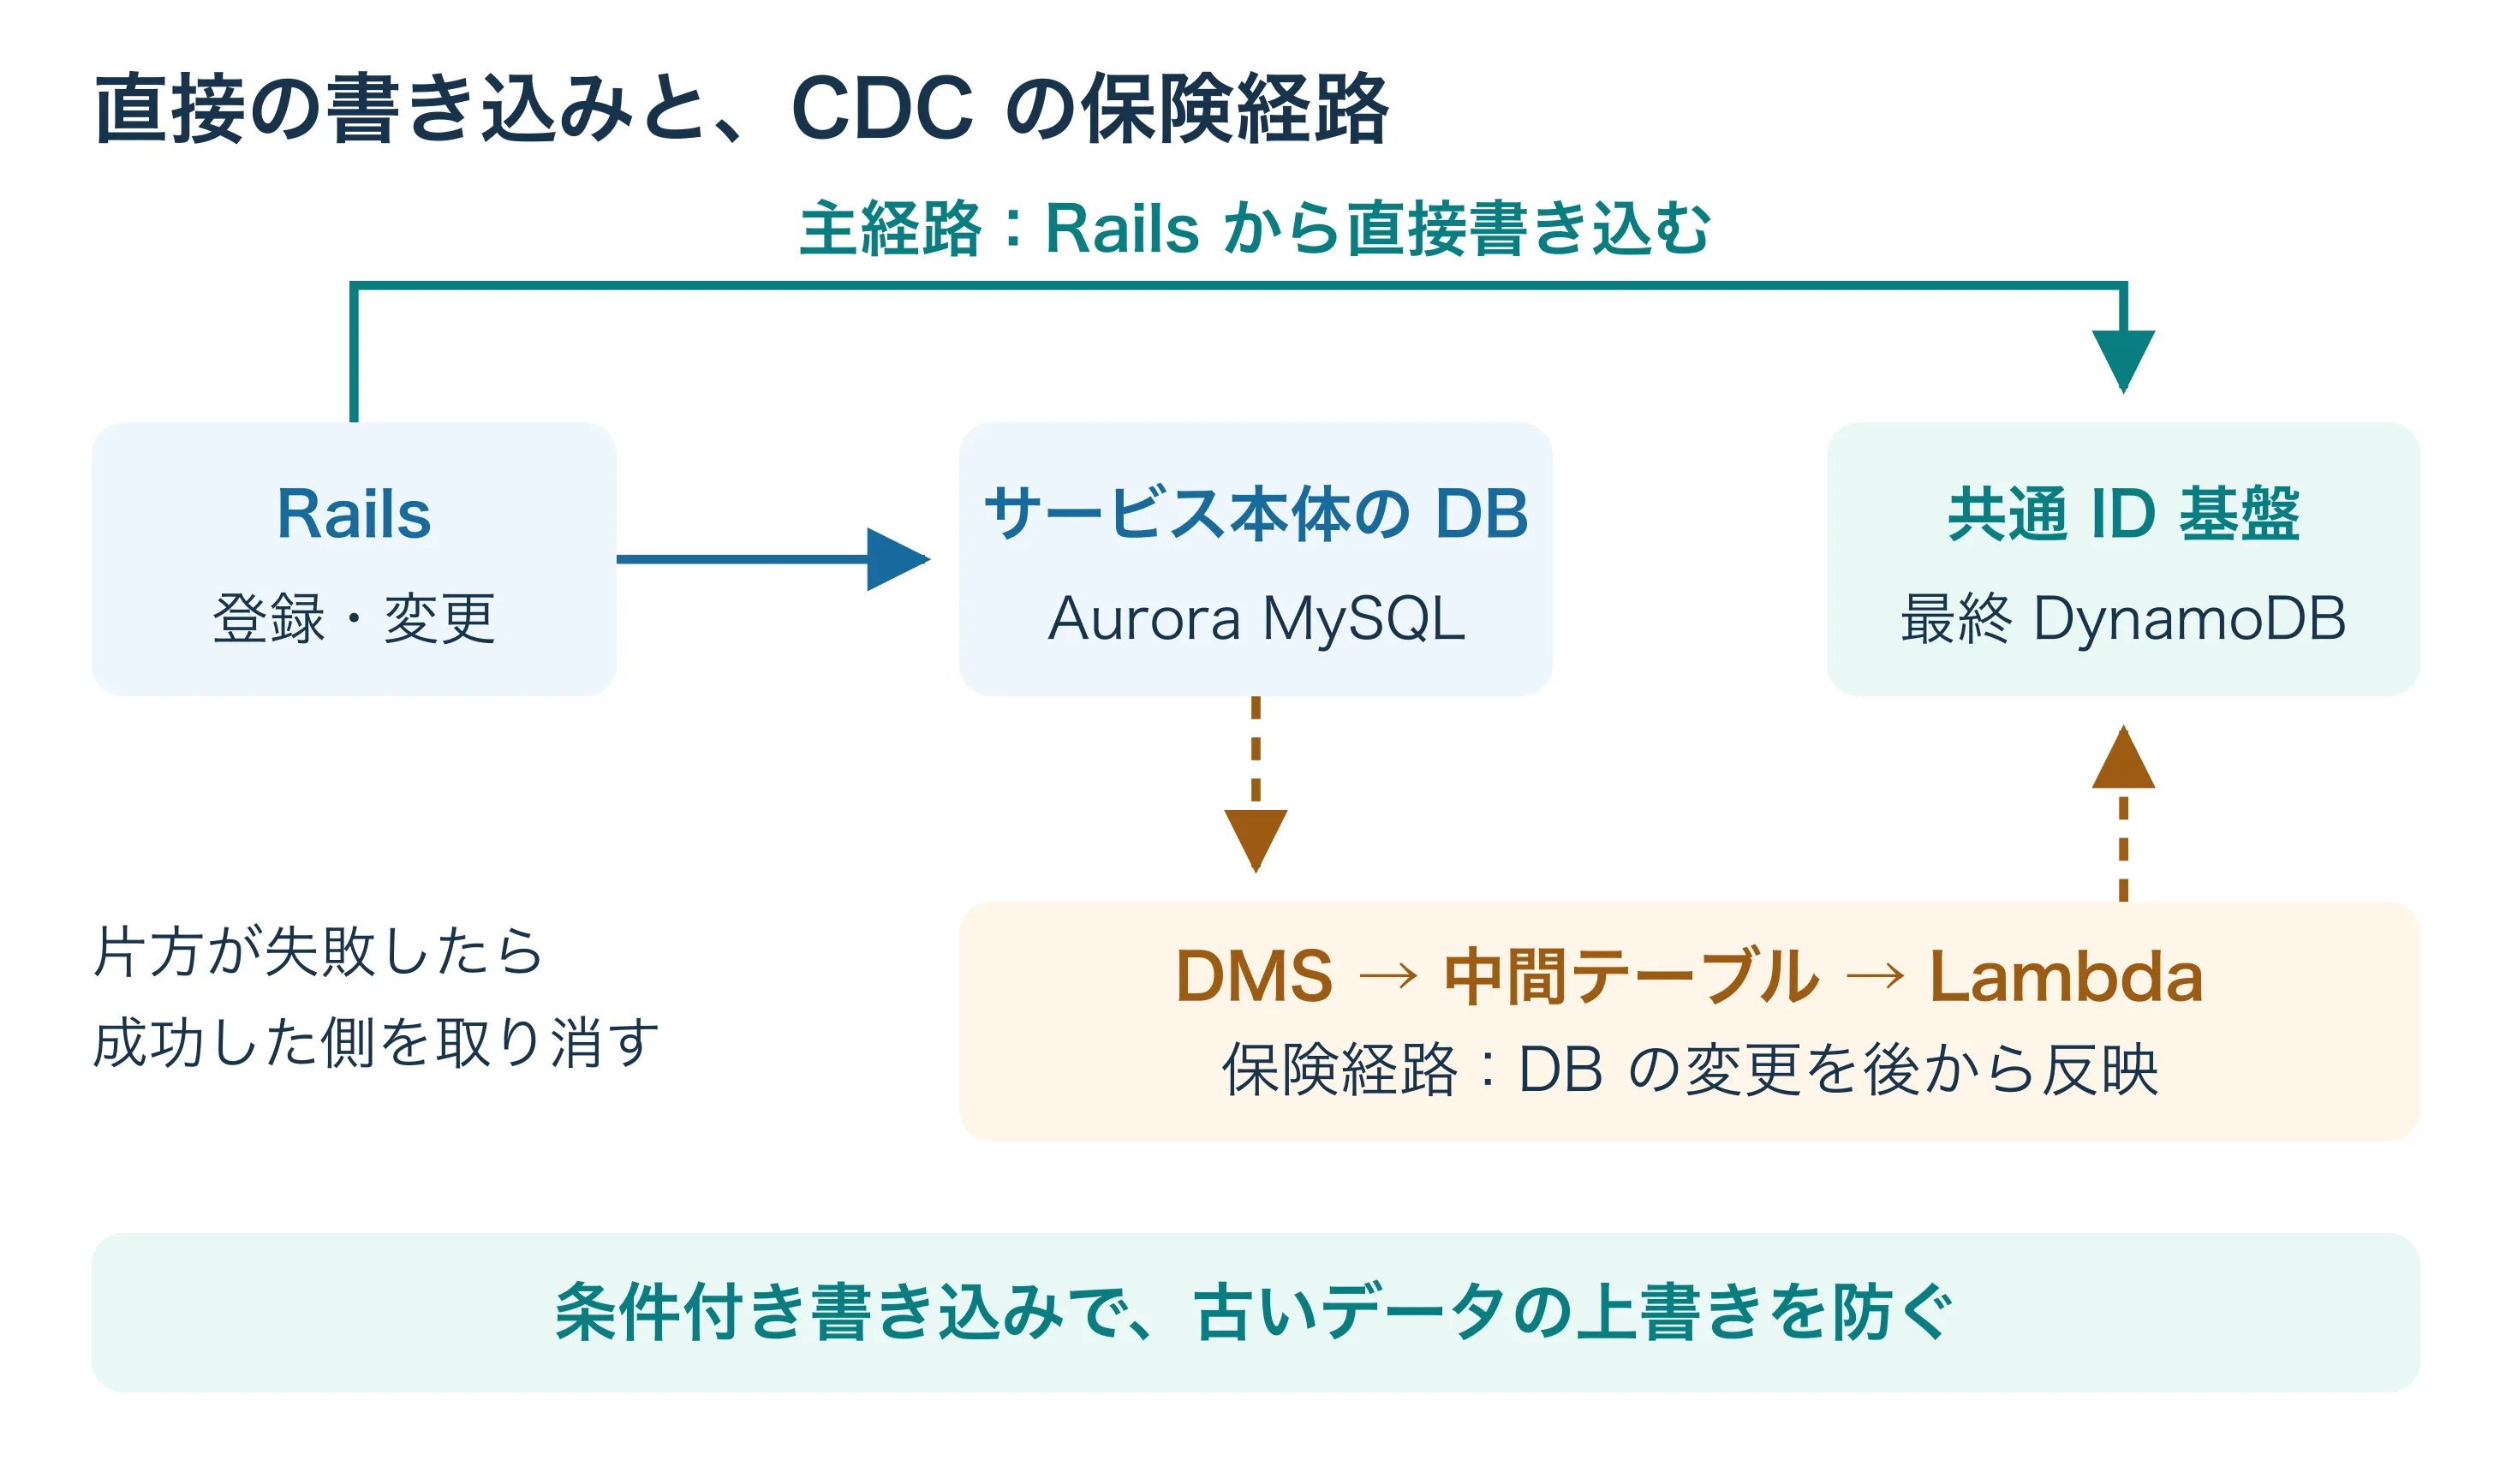
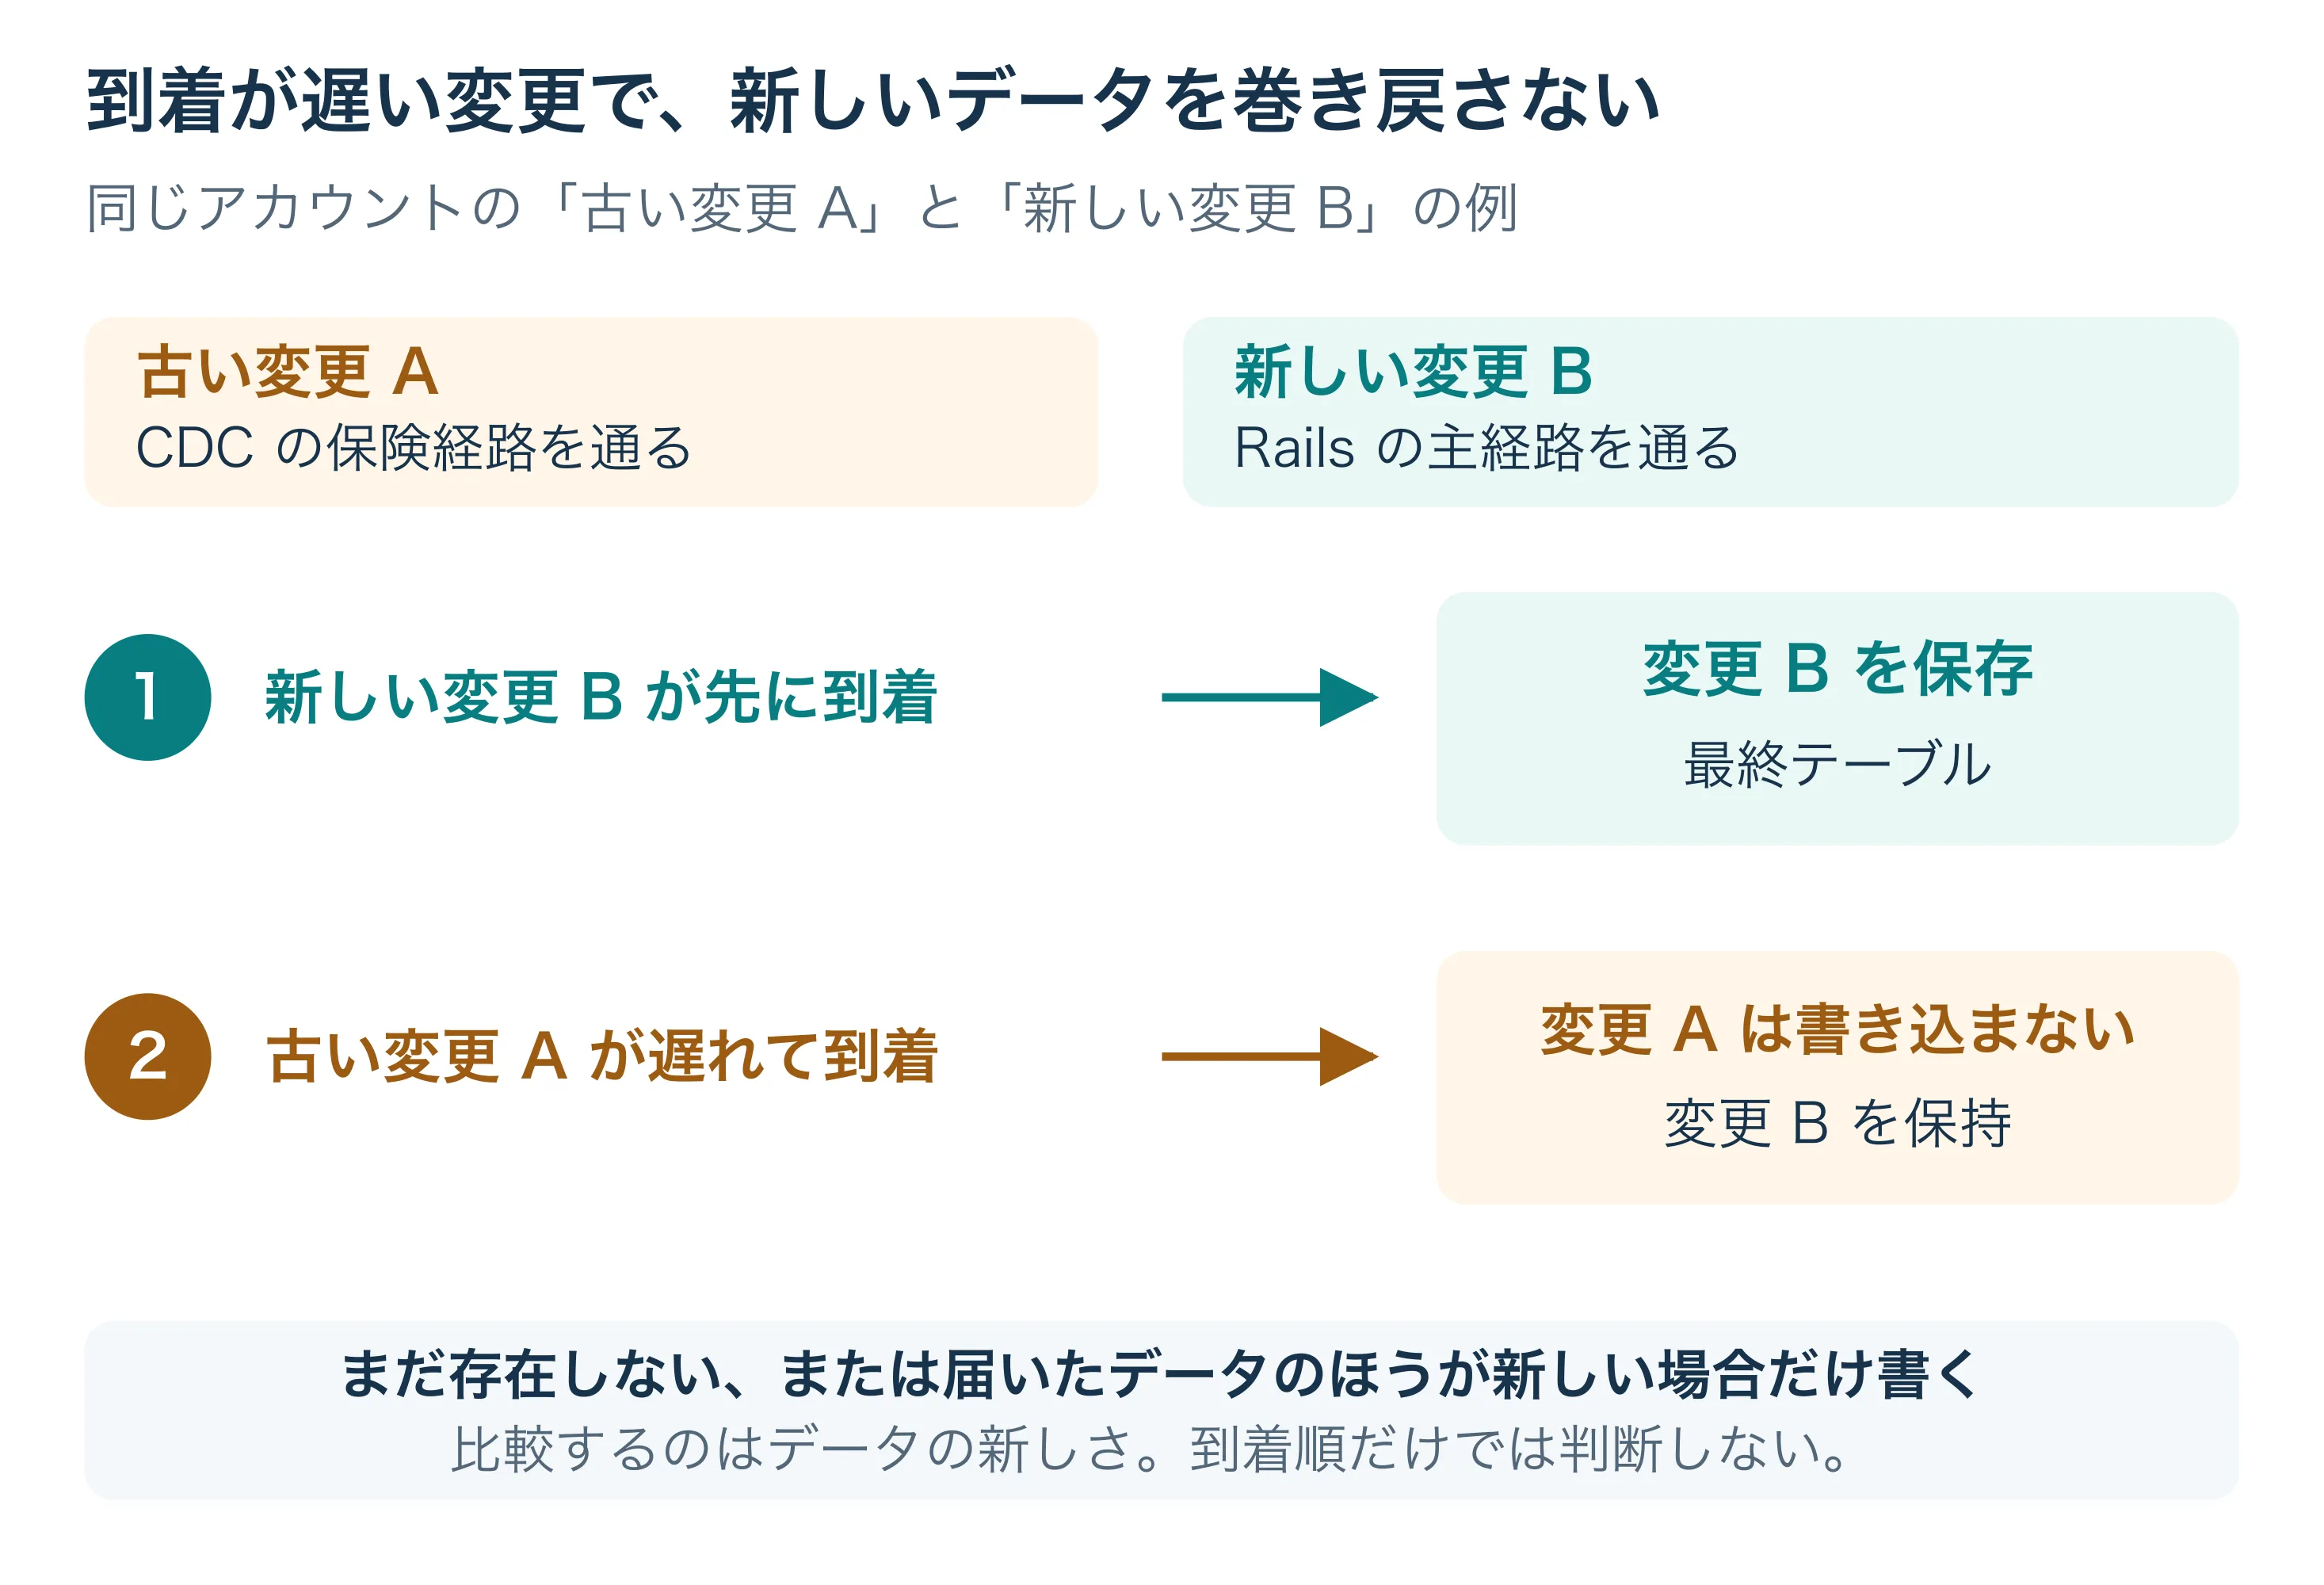
主経路で何らかの理由で取りこぼした変更があっても、保険経路が後から追いつきます。2つの経路が同じアカウントを書き込むので、最終テーブルへの書き込みは、DynamoDB の条件付き書き込みで「まだ存在しないか、自分のほうが新しいときだけ書く」ようにしました。後から届いた古い変更が、新しい変更を上書きすることはありません。
例えば、同じアカウントに古い変更 A と新しい変更 B があったとします。新しい変更 B が主経路で先に保存され、その後に古い変更 A が CDC 経由で届いても、A の書き込みは条件を満たさないため行いません。比較するのはデータの新しさであり、到着した順番ではありません。
また主経路では、2つの書き込みのうち片方だけが失敗した場合、成功した側の変更を取り消します(補償処理)。片方だけが更新された状態を残さないためです。
保険経路は移行期間中だけのものです。主経路が安定して動いていることを確かめてから止め、最後に削除しました。この流れは次の章で説明します。
移行のフェーズ
事業者向けアカウントのときは、パイプラインの構築から撤去までを一晩で終えていました。求職者向けアカウントは20倍近い規模があり、問題が起きたときの影響も大きくなります。そこで、戻せる段階をあえて長く残す進め方に変えました。
まず全体の流れを示します。保険経路を止めてから削除するまでに、1週間の観察期間を置きました。
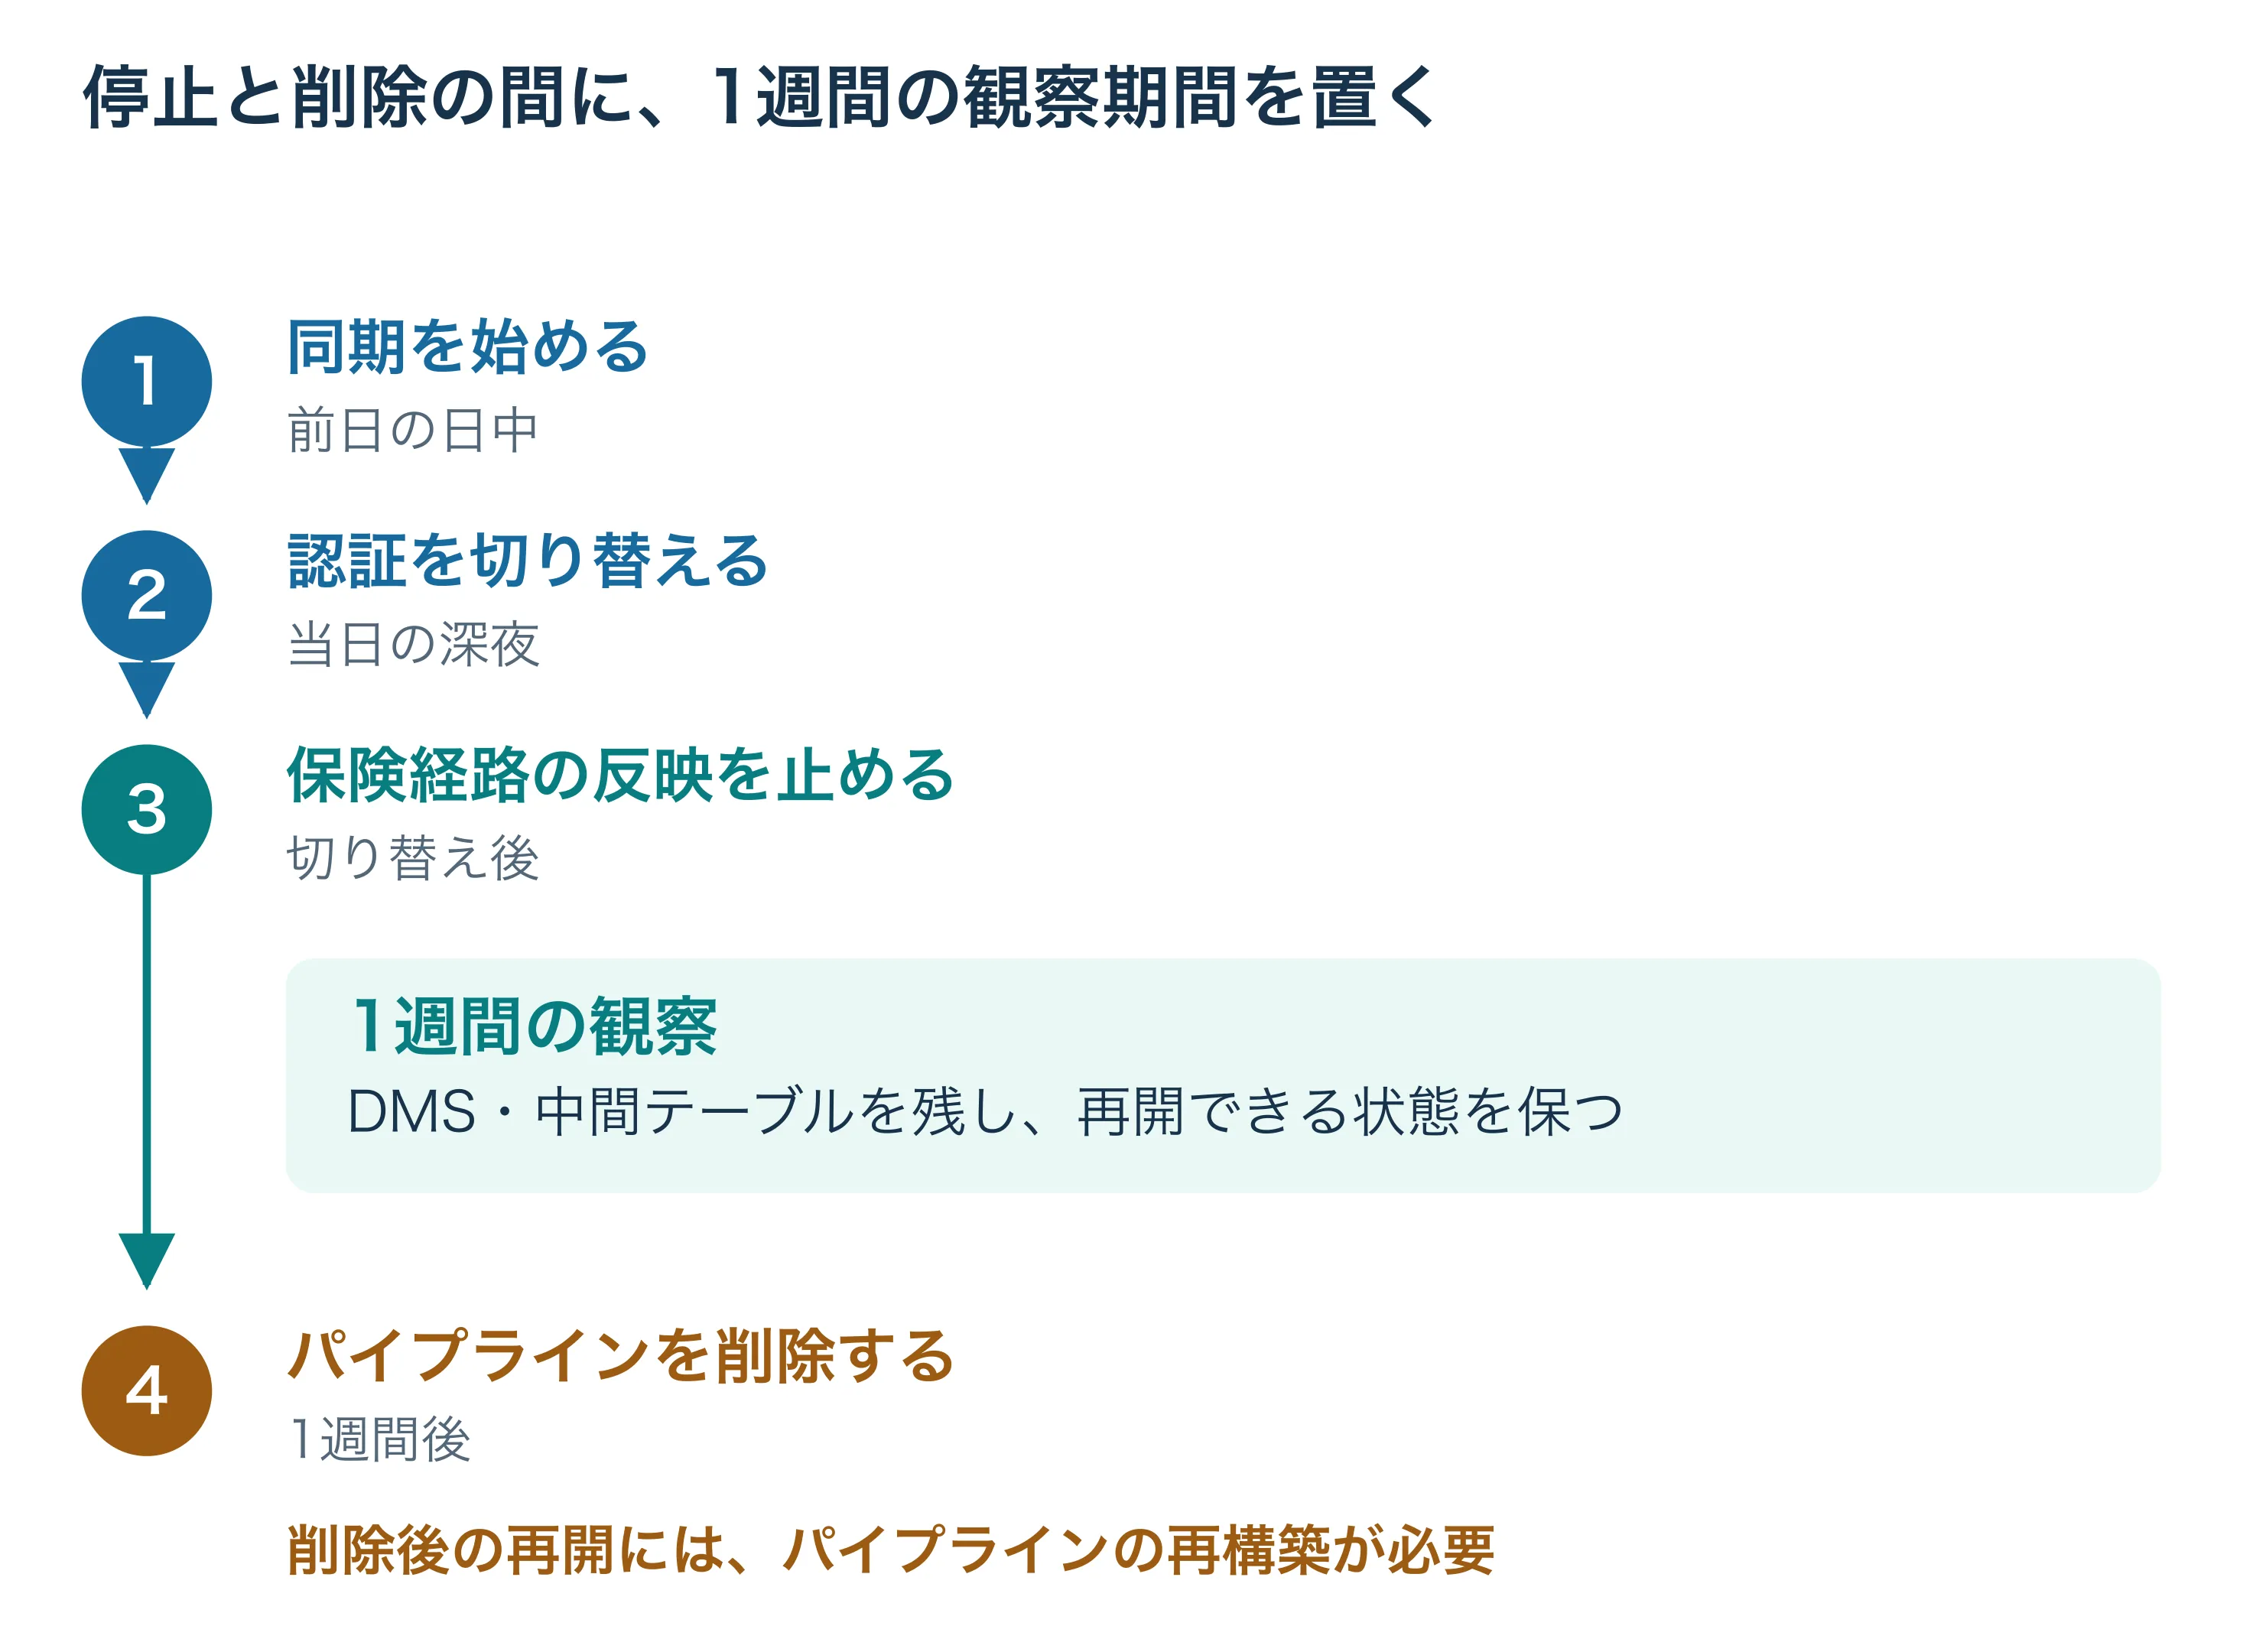
各フェーズの作業と、戻せる範囲は次の通りです。
| フェーズ | タイミング | やること | 戻せるか |
|---|---|---|---|
| 0. 移行前 | - | 認証は全てサービス本体のデータベース | - |
| 1. 同期 | リリース前日の日中 | フルロードと CDC を開始し、件数などを突き合わせる | 戻せる |
| 2. 切り替え | リリース当日の深夜 | フィーチャーフラグを ON にして、パスワードの照合を共通 ID 基盤へ | 戻せる |
| 3. 保険経路を止める | 切り替えの直後 | CDC の反映を止めて、1週間観察する | すぐ戻せる |
| 4. 削除 | フェーズ 3 の1週間後 | パイプラインを削除する(移行完了) | 戻せない |
1. フルロードと変更の継続同期(リリース前日の日中)
リリースの前日に、AWS DMS のフルロードと CDC を始めます。300万件以上のフルロードは数時間かかるため、日中に始めて、夜までに終わらせます。
フルロードが終わったら、移行元と移行先の件数を突き合わせ、サンプルを抜き出して中身も確認します。この時点では、ログインはまだサービス本体のデータベースで照合しているので、ユーザーへの影響はありません。
2. 深夜にフィーチャーフラグで切り替え(リリース当日の深夜)
パスワードの照合を共通 ID 基盤へ切り替えるのは、利用者の少ない深夜にしました。切り替えはフィーチャーフラグで行います。フラグを ON にした Rails をデプロイすると、パスワードを照合するストラテジーが共通 ID 基盤の API を呼ぶものに替わります。
切り替えた後は、共通 ID 基盤の API のエラー率と応答時間を見て、ログインが正常に動いていることを確かめました。
3. 保険経路を止めて1週間観察する(切り替えの直後)
主経路が安定して動いていることを確かめたら、CDC の反映を止めます。止めるのは、中間テーブルから最終テーブルへ書き込む Lambda の起動だけです。AWS DMS と中間テーブルは動かしたまま残します。
こうしておくと、問題が起きたときは Lambda の起動を有効に戻すだけで、保険経路を再開できます。この「すぐ戻せる」状態のまま、1週間観察しました。観察したのは、共通 ID 基盤への書き込み漏れ、エラー率、エラー監視ツールの通知件数などです。
4. パイプラインを削除する(移行完了)
1週間経っても問題がなかったので、パイプラインを削除しました。削除したのは、AWS DMS のタスクとインスタンス、中間テーブル、Lambda です。
ここから先は、保険経路を元に戻すにはパイプラインを作り直す必要があり、数日かかります。だからこそ、削除の前に1週間の観察期間を置きました。この削除をもって、移行は完了です。
リハーサルで当日の手順を固める
本番の前に、検証環境で手順を繰り返し試しました。環境ごとに役割を分けています。
- 開発用の検証環境: 機能ごとの動作確認。新規登録・ログイン・パスワード変更・退会などを、フラグを ON にした状態で一つずつ確かめる
- 本番に近い構成の検証環境: 本番と同じ手順のリハーサル。パイプラインの構築からフェーズ 3 までを、本番用のスクリプトで通しで実行する
後者の環境では、深夜の利用を模した負荷をかけながら CDC が追いつくかも確かめました。リハーサルのたびに、手順書の所要時間を実測値で書き直しています。リハーサルの後片付けと、もう一度きれいな状態から実行できるかも確認しました。本番当日は、この手順書通りに進めました。
事前に潰した罠と、当日に起きたこと
フラグを ON にするまで見えないバグ
フィーチャーフラグで認証方式を切り替える場合、全ての画面がフラグを見る処理を通っていることが前提になります。そこで設計の段階で、認証が絡む処理を洗い出しました。ログイン、新規登録、パスワード変更、パスワード再設定、退会、メールアドレス変更などを画面と API ごとに並べ、約30の流れを「共通 ID 基盤へ切り替える」「切り替え不要」に分けています。
それでも、洗い出しから漏れていた画面がありました。その画面だけは、通常のログインと同じ Devise のストラテジーを使わず、画面の中で独自にパスワードを照合していました。
フラグが OFF の間は、どちらもサービス本体のデータベースで照合するので、結果は変わりません。フラグを ON にした途端、この画面だけが共通 ID 基盤を使わずに照合を続け、ログインできなくなります。いわば時限式のバグです。
このバグは、リリースの前日に開発用の検証環境でフラグを ON にして動作確認したときに見つかりました。通常のログインと同じストラテジーを通すように直し、切り替えの前にリリースしています。併せて、同じような画面が他にないかを、コード全体で横断して調べました。
この教訓は、フラグの切り替えを試す動作確認を、主要なログイン画面だけで終わらせないことです。周辺の画面まで確かめる必要があります。
フルロード直後の取りこぼし
本番のフルロードが終わった後、中間テーブルと最終テーブルの件数を突き合わせると、数千件の差がありました。差分のアカウントを ID 単位で調べると、元のデータベースでの ID が若い番号に偏っていました。
原因は、起動のタイミングです。中間テーブルの変更を Lambda に流す仕組みは、「起動した時点より後の変更」だけを受け取る設定にしていました。AWS DMS のフルロードとこの仕組みをほぼ同時に起動したため、フルロードの最初の数十秒に書き込まれた分だけが、Lambda に届いていませんでした。
図のように、DMS が中間テーブルへ書き込み始めてから、Lambda に変更を渡す仕組みが受け取りを始めるまでに時間差がありました。その間のデータは中間テーブルには存在していましたが、最終テーブルには反映されていませんでした。
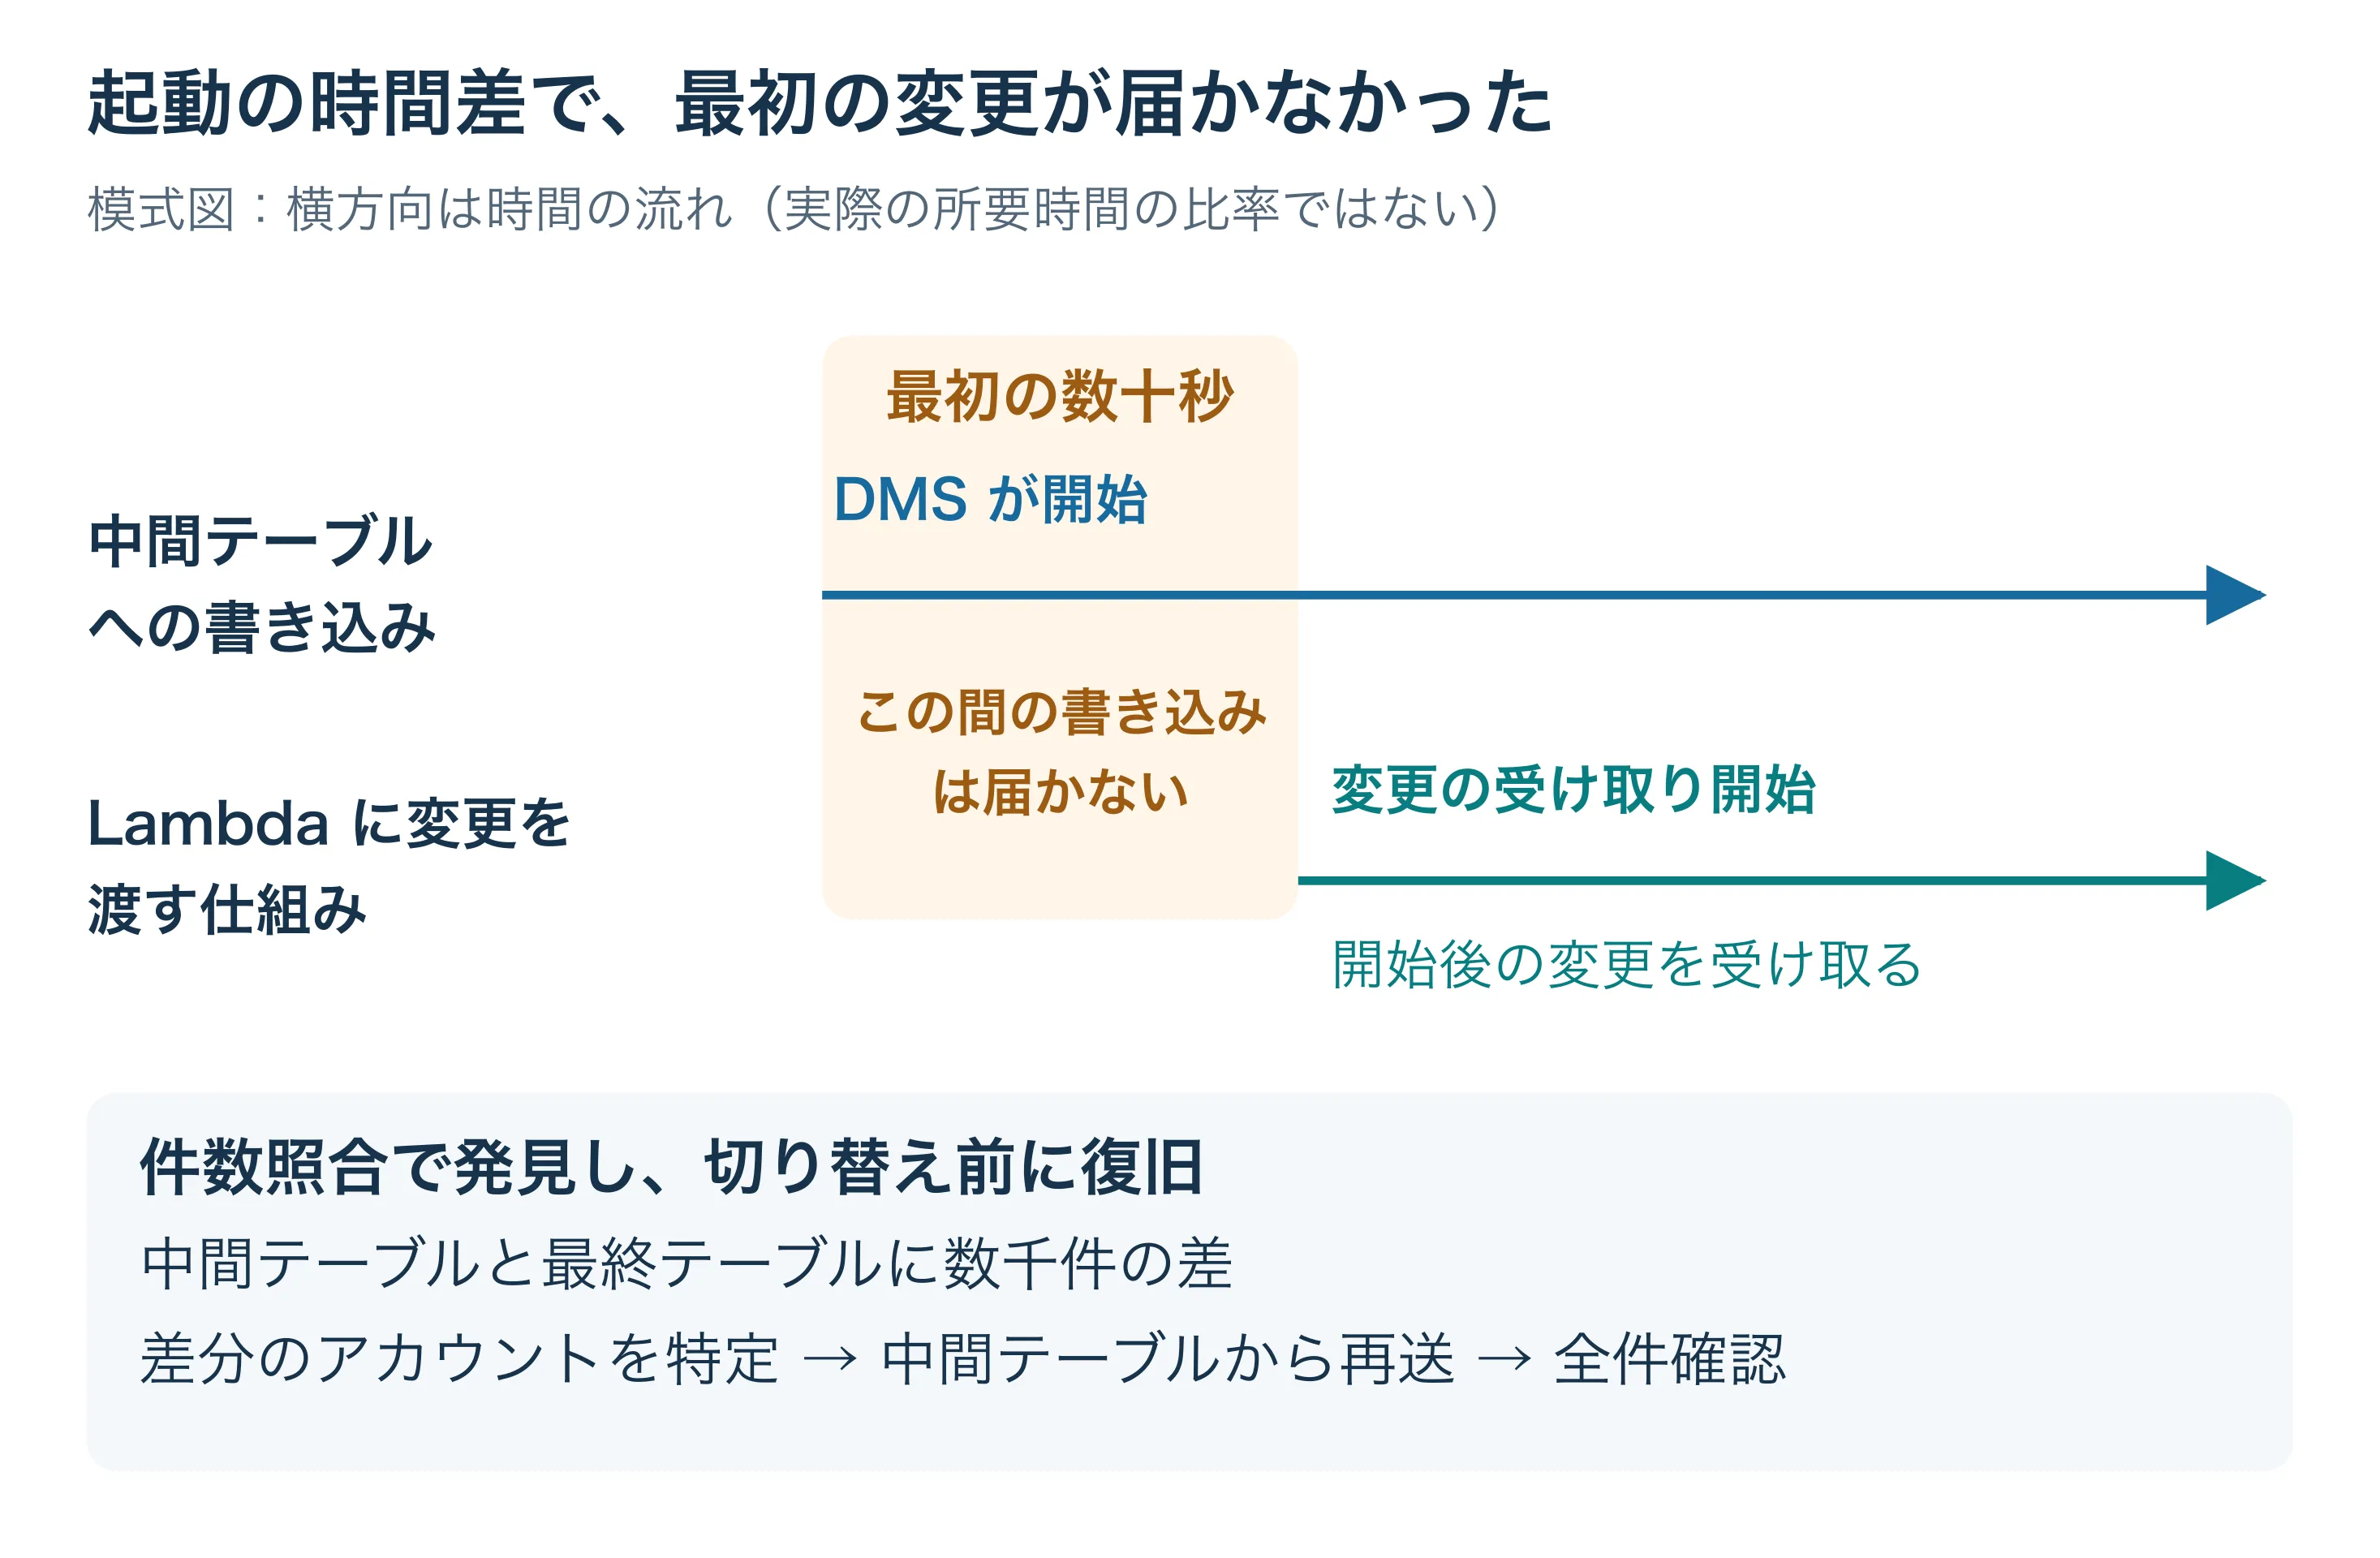
対象のアカウントを特定して中間テーブルから流し直し、全件が最終テーブルに揃ったことを確かめてから、切り替えに進みました。件数の突き合わせをフェーズ 1 の作業に入れていたので、切り替えの前に気づけました。
判断に使う指標が想定通りに上がらなかった
フェーズ 3 へ進むかどうかは、事業者向けアカウントのときと同じく、Lambda のログから出す指標で判断する予定でした。主経路が先に書き込み、CDC 経由の書き込みが「既に新しいので書かない」と判定された割合です。この割合が十分に高ければ、主経路だけで足りていると判断できます。
ところが本番では、この割合が想定通りに上がりませんでした。調べると、ログインした日時など、認証と関係のない列の更新も「書き込んだ」として数える実装になっていました。リハーサルのデータは認証周りの更新が中心だったので、この差が表に出なかったのです。
そこで、この指標の代わりに共通 ID 基盤の API の実測値を判断材料にしました。ログイン API のリクエスト数、エラー件数、応答時間です。併せて、実際にパスワードを変更したアカウントを抜き出し、主経路の書き込みログと CDC 側のログを突き合わせて、主経路が先に書き込み、CDC 側は「既に新しいので書かない」と判定されていることも確かめました。エラーがなく応答時間も安定しており、主経路で書き込めていることも確かめられたので、フェーズ 3 に進みました。
設計・実装を一人で進める中で AI をどう使ったか
メドレーでは生成AI利用のガイドラインが社内で展開されており、各部門の業務ではそのガイドラインに沿って利用をしています。
このプロジェクトでは、設計・実装・プロジェクト管理を私が一人で担当し、リリース当日の本番操作などはチームのメンバーと分担しました。設計や実装を一緒に検討するメンバーがいない中で抜け漏れを防ぐために、Claude Code のスキルを工程ごとに作りました。
工程ごとにスキルを作る
スキルは、作業の手順や守るルールを書いておくと、Claude Code が必要なときに読み込んで従ってくれる仕組みです。工程ごとに次のようなスキルを用意しました。
- 設計: 未決の論点を一つずつ取り上げ、選択肢と判断の根拠を整理する
- 実装: 移行で守るルールを持たせる。例えば「既存のパスワードハッシュは再ハッシュしない」「ID は決まった入力から生成する」
- レビュー: アーキテクチャ・ベストプラクティス・テストの観点ごとにレビュー役を分け、繰り返し確認する
- 動作確認: 画面のスクリーンショットから、「操作前 → 操作 → 操作後」の流れが一目で分かる画像を作り、PR に貼る
一人で進めると、自分の思い込みに気づく機会が少なくなります。AI にはブレーキ役と検算役を任せ、抜け漏れを指摘してもらうように使いました。
セルフプロジェクト管理に使う
プロジェクト管理にもスキルを使いました。
- 日次・週次の振り返り: その日にやったことと次にやることを整理し、週の終わりにまとめる
- 作業ログの保存: 作業の最後に、やったこと・調べたこと・決めたこと・残った課題を記録する
保存した作業ログは、翌日の自分への引き継ぎになります。数か月にわたるプロジェクトでも、「なぜこう決めたのか」を後から確かめられました。
これは個人レベルの工夫ですが、作業ログは Obsidian で管理している自分用のナレッジベース(いわゆる「セカンドブレイン」)に溜めています。作業ログから、他の作業でも使える学びだけを知識のノートとしてまとめ直しておき、次の作業を始める前に AI がそこから関連する罠を検索してから着手するようにしました。例えば、リリース当日に起きたフルロード直後の取りこぼしは、似た現象を検証環境で踏んだときのノートがあったので、原因の見当を早くつけられました。
判断は人がする
AI と人の役割は、作業の内容ごとに分けました。基本の考え方は、AI が材料をそろえ、人が決めて実行するです。
| 作業 | AI がしたこと | 人がしたこと |
|---|---|---|
| 設計 | 先行した事業者向けの移行との違いを洗い出し、論点ごとに選択肢と根拠を並べる | どの選択肢を採るかを決める(例: 撤去を「止める」「消す」の2段に分け、間に1週間置く) |
| 実装 | 移行のルールに沿ってコードとテストを書き、観点別にレビューする | 検証環境で画面を実際に操作して、期待通りに動くかを確かめる |
| リリース当日 | 移行元と移行先の件数を突き合わせ、差分のアカウントを特定する。指標が上がらない原因をコードと変更履歴から調べ、代わりに使える API の実測値を集計する | 取りこぼしの復旧を実行する。代わりの判断材料で次のフェーズに進むかを決める |
| 撤去 | 削除の前後で、残っているリソースと影響範囲を確認する | 戻せなくなる削除を実行するかを決めて、実行する |
本番のデータを書き換える操作と、戻せなくなる判断は、全て人が行いました。AI の調査結果も、そのまま判断に使うのではなく、元のデータやコードで裏を取ってから使っています。
おわりに
300万件以上の求職者向けアカウントを、ログアウトさせず、パスワードの再設定もさせずに、共通 ID 基盤へ移行しました。リリースは大きな障害なく完了しています。
振り返ると、効いたのは次の3つでした。
- 移すものを絞る: ログイン状態の確認は移さず、パスワードの照合だけを移す。触らない値を決めることが、ログアウトさせない設計の中心でした
- 戻せる段階を残す: 保険経路を「止める」と「消す」に分け、間に1週間の観察を置く
- フラグの外側を探す: フラグを ON にするまで見えないバグは、認証が絡む処理の洗い出しと、周辺の画面まで含めた動作確認で潰す
同じように、サービスを止めずに認証基盤を移したい方の参考になれば嬉しいです。
参考
We’re hiring
メドレーでは、共通 ID 基盤のような全社のサービスを支える基盤づくりをはじめ、「医療ヘルスケアの未来をつくる」ことに取り組むエンジニアを募集しています。ご興味をお持ちいただけましたら、ぜひご応募ください。
※カジュアル面談も大歓迎です!ご希望の際は、「その他の項目(希望記入欄)」にてその旨をご記載ください。